اطلع على آخر الأخبار والتحديثات لتكون أول من تصله المعرفة الحديثة
ChatGPT vs Claude vs Gemini 2026: مقارنة شاملة لأقوى نماذج الذكاء الاصطناعي

مقارنة شاملة بين ChatGPT وClaude وGemini في 2026 من حيث البرمجة والاستدلال، نافذة السياق، الوسائط المتعددة، الوكلاء، التكلفة وأفضل استخدام لكل نموذج.
صراع العمالقة الثلاثة: جيميناي وكلود وشات جي بي تي في هندسة الذكاء الاصطناعي التوليدي 2026
يشهد المشهد التكنولوجي في عام 2026 مرحلة جديدة تتجاوز مفهوم نماذج اللغات الكبيرة (LLMs) بصورتها التقليدية؛ فالذكاء الاصطناعي لم يعد مجرد محرك دردشة يولّد النصوص، بل أصبح طبقة تشغيل قادرة على الاستدلال، والبحث، وكتابة البرمجيات، واستخدام الحاسوب، واستدعاء الأدوات، والعمل داخل الملفات والتطبيقات. ويتصدر المنافسة اليوم ثلاثة أنظمة رئيسية: ChatGPT ومنظومة OpenAI التي تضم GPT-6 Astra وعائلة GPT-5.6، وClaude من Anthropic مع Claude Sonnet 5 وClaude Opus 5، وGemini من Google DeepMind الذي وصل إلى عائلة Gemini 3.8 ونماذج Gemini Live المتخصصة في التفاعل الفوري.
المحتويات
لذلك لم يعد السؤال الهندسي الصحيح هو: “أي نموذج هو الأذكى؟”، بل: أي منظومة تستطيع إنهاء نوع العمل الذي أقوم به بأعلى دقة، وأقل تكلفة، وأقل تدخل بشري، مع القدرة على التحقق من النتائج؟ فالنموذج الذي يتفوق في مشروع برمجي طويل قد لا يكون الخيار الاقتصادي لمعالجة مليون مستند، والنظام الأفضل للصوت والفيديو قد لا يكون الأكثر ملاءمة لمراجعة Pull Request معقدة. ولهذا تقارن هذه المقالة بين المنصات الثلاث على مستوى الاستدلال، والبرمجة، والسياق، والوسائط، والوكلاء، والتكلفة الفعلية بدلاً من الاكتفاء باختبارات الذكاء النظرية.
أصبحت التكنولوجيا في تطوير الذات خلال عام 2026 أكثر من مجرد مجموعة من التطبيقات والدورات التعليمية. فمع انتشار أدوات الذكاء الاصطناعي، ومنصات التعلم الإلكتروني، وتطبيقات إدارة العادات والتركيز، بات بإمكان أي شخص بناء نظام شخصي يساعده على التعلم بصورة أسرع، وتنظيم وقته، واكتساب مهارات جديدة، وتحسين إنتاجيته.
اكتشف كيفية استخدام الذكاء الاصطناعي والتكنولوجيا في تطوير الذات
المعمارية التقنية والبنية التشغيلية: ماذا نعرف فعلاً تحت غطاء النماذج؟
ينبغي هنا تصحيح مفهوم شائع في المقارنات التقنية: الشركات الثلاث لا تنشر جميع تفاصيل البنية الداخلية لنماذجها الرائدة، ولذلك لا يصح الجزم بعدد الخبراء أو المعلمات أو الادعاء بأن نموذجاً بعينه يستخدم بنية Mixture of Experts ما لم تُعلن الشركة ذلك صراحة. الأكثر فائدة للمهندس هو مقارنة المعمارية التشغيلية: طريقة الاستدلال، نافذة السياق، الأدوات، الذاكرة، استخدام الحاسوب، وإدارة المهام الطويلة.
- منظومة OpenAI – GPT-6 Astra وGPT-5.6: انتقلت OpenAI إلى نماذج استدلالية تستطيع تغيير مستوى الجهد الحسابي حسب صعوبة المهمة، مع تكامل مباشر مع البحث، وتحليل الملفات، وتشغيل الشيفرات، واستخدام الحاسوب، واستدعاء الأدوات والوظائف. ويستهدف GPT-6 Astra الأعمال الأصعب من البداية إلى النهاية، بينما توفر عائلة GPT-5.6 مستويات Sol وTerra وLuna لموازنة القدرة والسرعة والتكلفة.
- منظومة Anthropic – Claude 5: يركز Claude Sonnet 5 وClaude Opus 5 على Adaptive Thinking والعمل الوكيلي طويل المدى، حيث يستطيع النموذج التخطيط واستخدام الطرفية والمتصفح والأدوات ومراجعة عمله خلال سلسلة طويلة من الخطوات. وتظل منهجية Constitutional AI جزءاً مهماً من فلسفة المواءمة والسلامة لدى Anthropic، لكنها منهج تدريب ومواءمة وليست وصفاً لمعمارية الشبكة العصبية نفسها.
- منظومة Google – Gemini 3.8: يتميز Gemini بتصميم متعدد الوسائط على مستوى المنتج وواجهات التطوير، مع دعم النص والصورة والصوت والفيديو وملفات PDF، إضافة إلى البحث وGoogle Maps وتنفيذ الأكواد واستخدام الحاسوب واستدعاء الوظائف. ويجمع Gemini 3.8 Flash بين الاستدلال والسرعة والعمل الوكيلي، بينما تتخصص Gemini 3.8 Live في الحوار الصوتي والمرئي في الزمن الحقيقي.
نافذة السياق والذاكرة التشغيلية: عصر المليون Token لم يعد حكراً على نموذج واحد
تمثل نافذة السياق (Context Window) كمية المعلومات التي يستطيع النموذج التعامل معها داخل طلب أو سلسلة معالجة واحدة، وهي عامل مهم عند تحليل قواعد الشيفرات الضخمة، والعقود، والمواصفات الهندسية، والأبحاث الطويلة. لكن حجم النافذة وحده لا يضمن استرجاع كل معلومة بدقة؛ فالكفاءة الحقيقية تعتمد أيضاً على جودة الانتباه، وطريقة تنظيم المدخلات، والبحث داخل الملفات، والتخزين المؤقت، وآليات ضغط السياق.
يوفر Gemini 3.8 Flash نافذة إدخال تبلغ نحو 1,048,576 رمزاً مع أقصى إخراج يصل إلى 65,536 رمزاً، ويدعم داخل السياق نفسه النصوص والصور والصوت والفيديو وملفات PDF. وهذا يجعله مناسباً بصورة خاصة للمهام التي تجمع أنواعاً متعددة من البيانات؛ مثل تحليل تسجيل اجتماع طويل مع مستندات المشروع والصور والملفات المرافقة، أو فحص أجزاء واسعة من مستودع برمجي واحد.
لكن الفارق تقلص جذرياً عن الأجيال السابقة؛ إذ يوفر Claude Sonnet 5 وClaude Opus 5 نافذة سياق تبلغ مليون Token مع إمكانية إخراج تصل إلى 128 ألف Token، بينما يصل GPT-5.6 Sol وGPT-6 Astra إلى نحو 1.05 مليون Token مع أقصى إخراج يبلغ 128 ألف Token. وبالتالي لم يعد من الصحيح اختيار المنصة بناءً على رقم السياق وحده. كما يجب عدم الخلط بين نافذة السياق وميزة Memory في تطبيقات الدردشة؛ فالأولى ذاكرة عمل للطلب، أما الثانية فآلية منفصلة للاحتفاظ ببعض السياق عبر المحادثات.
مقارنة الأداء في البرمجة وهندسة البرمجيات: من يكتب الكود الأقوى والأكثر أماناً؟
تحولت المنافسة البرمجية من سؤال “من يكتب الدالة الصحيحة؟” إلى اختبار أصعب بكثير: هل يستطيع النموذج فهم مستودع حقيقي، تحديد السبب الجذري للخلل، تعديل عدة ملفات، تشغيل الاختبارات، اكتشاف فشل جديد، ثم إصلاحه قبل تسليم النتيجة؟ ولهذا أصبحت اختبارات هندسة البرمجيات الواقعية والوكلاء طويلة المدى أكثر أهمية من مسابقات توليد الشيفرات القصيرة، كما يجب قراءة أي Benchmark مع معرفة الـHarness ومستوى التفكير والأدوات والميزانية المستخدمة في الاختبار.
1. Claude Sonnet 5 وOpus 5: قوة كبيرة في البرمجة الوكيلية وتصحيح الأنظمة القائمة
أصبح Claude واحداً من أبرز الخيارات للمشروعات البرمجية الطويلة بفضل التكامل بين نماذج Claude 5 وبيئة Claude Code. يتعامل Sonnet 5 بكفاءة مع الاستكشاف المتدرج للمستودعات، واستخدام الطرفية، وكتابة الاختبارات، وتتبع الأعطال عبر عدة ملفات، بينما يرفع Opus 5 مستوى التحليل في مهام إعادة الهيكلة وتصحيح الأخطاء المعقدة والعمل الوكيلي الممتد. وتبقى ميزة Claude الأهم هنا ليست “كتابة أكبر كمية من الكود”، بل المحافظة على خطة العمل ومراجعة النتائج عبر دورات تنفيذ متعددة.
2. ChatGPT وCodex مع GPT-6 Astra وGPT-5.6: من الكود إلى التنفيذ الكامل
تطورت منظومة OpenAI من مولد شيفرات إلى بيئة عمل كاملة؛ إذ يستطيع Codex التعامل مع المستودعات والمجلدات المحلية والطرفية والمتصفح واستخدام الحاسوب، بينما تجمع نماذج GPT الحديثة بين الاستدلال وكتابة الشيفرات وتحليل الملفات والبحث وتشغيل الأدوات. ويصبح هذا مفيداً خصوصاً عندما لا تنتهي المهمة عند تعديل الكود، بل تشمل تحليل البيانات، وإنشاء ملفات، والتحقق من تطبيق ويب في المتصفح، أو تنفيذ سلسلة إجراءات كاملة قبل تسليم الناتج النهائي.
3. Gemini 3.8 Flash: هندسة برمجيات سريعة ووكلاء على نطاق واسع
لم يعد Gemini مجرد خيار لمعالجة السياقات الضخمة؛ فقد صُمم Gemini 3.8 Flash صراحة لمهام هندسة البرمجيات طويلة المدى والوكلاء المستقلين وإعادة الهيكلة متعددة الملفات. ويمنحه الجمع بين نافذة المليون Token، وتنفيذ الأكواد، والبحث، وComputer Use، واستدعاء الوظائف، وسعر API المنخفض نسبياً موقعاً مهماً في الأنظمة التي تحتاج إلى تشغيل أعداد كبيرة من الوكلاء أو تنفيذ تدفقات برمجية كثيرة مع مراقبة صارمة للتكلفة.
المنطق الرياضي وحل المشكلات المعقدة: مقارنة نماذج التفكير والاستدلال الحديثة
لم يعد الاستدلال في 2026 ميزة منفصلة لنماذج قليلة، بل أصبح طبقة أساسية يمكن التحكم في شدتها. ومن الخطأ تقييم النماذج عبر MMLU أو GSM8K وحدهما؛ فالمقارنة الحديثة تشمل الاستدلال الجديد غير المحفوظ، والعمل المهني، واستخدام الأدوات، والقدرة على الحفاظ على خطة صحيحة عبر عشرات الخطوات. كما تؤثر إعدادات Reasoning Effort في الجودة والسرعة واستهلاك الرموز، ولذلك قد يعطي النموذج نفسه نتائج مختلفة جذرياً وفق إعداد التشغيل.
- OpenAI GPT-6 Astra وGPT-5.6 Sol: توفر النماذج مستويات متعددة لجهد الاستدلال، وتستهدف Astra تحديداً أصعب الأعمال المتكاملة في البرمجة والعلوم والبحث والعمل المهني. الميزة العملية هي قدرة النموذج على الجمع بين الاستدلال والأدوات والبحث واستخدام الحاسوب بدلاً من معالجة المسألة كنص معزول فقط.
- Claude Opus 5 وSonnet 5: يعتمدان على Adaptive Thinking مع مستويات جهد مختلفة، وهو ما يسمح بموازنة عمق التفكير مع التكلفة والزمن. ويظهر أثر ذلك خصوصاً في المهام التي تحتاج إلى التخطيط، والتحقق من العمل، وإعادة المحاولة، والحفاظ على اتساق القرارات خلال مهمة طويلة.
- Gemini 3.8 Flash وGemini 3.8 Live Extended Thinking: يدعم Flash مستويات تفكير قابلة للضبط، بينما نقلت Google الاستدلال أيضاً إلى البيئة الصوتية عبر Live Extended Thinking، بحيث يستطيع النظام مواصلة استدلال متعدد الخطوات في الخلفية أثناء التفاعل الصوتي وتنفيذ الأدوات غير المتزامنة.
معالجة الوسائط المتعددة (Multimodality): الصوت، الصورة، والفيديو في ميزان الاختبار
أصبح وصف أي نموذج بأنه “متعدد الوسائط” غير كافٍ، لأن نوع الدعم يختلف بين واجهة الدردشة وواجهة API وبين النموذج الأساسي والنماذج المتخصصة. وقد تدعم المنصة الفيديو في نموذج، والصوت الفوري في نموذج آخر، والصور فقط في نموذج الاستدلال الرئيسي؛ لذلك يجب تقييم مسار العمل الكامل وليس اسم العلامة التجارية وحده.
- معالجة الفيديو والبيانات المتعددة: يمتلك Gemini 3.8 Flash ميزة واضحة في API لأنه يقبل النصوص والصور والصوت والفيديو وPDF ضمن نموذج واحد وبنافذة تصل إلى نحو مليون Token. وهذا مفيد لتحليل التسجيلات والمحاضرات والفيديوهات الفنية وربطها بمستندات مكتوبة أو بيانات أخرى في الطلب نفسه.
- الصور والمستندات والرسومات: تدعم نماذج OpenAI الحديثة إدخال النص والصورة مع أدوات إضافية لمعالجة الملفات، بينما يدعم Claude النصوص والصور وPDF ويتميز ببيئات Artifacts وإنشاء المخرجات التفاعلية. أما Gemini فيجمع الصور وPDF والوسائط الزمنية داخل واجهة واحدة، ولذلك يعتمد الاختيار على ما إذا كان المطلوب مجرد تفسير صورة أم تحليل مجموعة ملفات ووسائط مترابطة.
- الصوت الطبيعي والتفاعل اللحظي: أصبح السباق أكثر تقارباً. يستخدم ChatGPT الصوتي GPT-Live-1 في الخطط المدفوعة مع الاستماع والتحدث المتزامنين والتعامل الطبيعي مع المقاطعات، بينما يوفر Gemini 3.8 Live إدخال النص والصورة والصوت والفيديو وإخراج الصوت مباشرة، وتضيف نسخة Extended Thinking استدلالاً أعمق أثناء الحوار الحي. لذلك لم يعد من الدقيق اعتبار الصوت ميزة محسومة لمنصة واحدة.
جودة الصياغة اللغوية والتعبير الأسلوبي: اختبار البلاغة واللغة العربية السليمة
تمثل اللغة العربية اختباراً مهماً للنماذج الحديثة بسبب ثرائها الصرفي واختلاف الفصحى عن اللهجات وتعدد الأساليب المهنية والأدبية. لكن لا يوجد حتى الآن اختبار عربي واحد شامل وموحّد يسمح بإعلان نموذج “الأفضل في العربية” بصورة علمية مطلقة؛ ولذلك ينبغي تقييم النماذج على عينة من النصوص الحقيقية التي تمثل استخدامك: تحرير مقالة، عقد، تقرير هندسي، حوار باللهجة المحلية أو ترجمة متخصصة.
يحافظ Claude عادة على اتساق جيد في النصوص الطويلة وإعادة التحرير المتكرر، وهي ميزة مفيدة عند العمل على مقالات وتقارير ومستندات كاملة. كما تسمح نافذة السياق الكبيرة بإبقاء المرجع والتعليمات والنص الأصلي داخل جلسة واحدة. ومع ذلك، تختلف جودة العربية باختلاف المجال والأمر المستخدم، ولا توجد بيانات رسمية كافية تبرر وصفه بأنه الأفضل مطلقاً في البلاغة العربية.
يمتاز ChatGPT بمرونة كبيرة في اتباع تعليمات النبرة والبنية وطول الإجابة وإعادة الكتابة، ويستفيد في التطبيق من أدوات البحث والملفات والذاكرة وسير العمل الطويل. وهذا يجعله مناسباً عندما يكون المطلوب الانتقال بين البحث والتحرير والتحليل وإنتاج ملفات مختلفة داخل مشروع واحد، مع ضرورة مراجعة المصطلحات المتخصصة وعدم اعتبار السلاسة اللغوية دليلاً على صحة المعلومات.
أما Gemini فيكتسب ميزة عملية عندما تكون الكتابة مرتبطة ببحث حديث أو ببيانات موجودة داخل Google Workspace؛ إذ يمكن ربط العمل بالمصادر الموجودة في Gmail وDrive وDocs وغيرها بحسب الصلاحيات المتاحة. وبالنسبة للمحتوى العربي المعرفي المتغير، فإن القدرة على Grounding بالبحث قد تكون أهم من الفروق الأسلوبية الصغيرة بين النماذج.
الأمان البرمجي والهلوسة المعرفية: موثوقية المخرجات والتحقق من المعلومات
تظل الهلوسة (Hallucination) — إنشاء معلومة أو رقم أو مرجع غير صحيح بصياغة تبدو واثقة — من أهم القيود التي تمنع الاعتماد غير المشروط على النماذج التوليدية. وحتى أقوى نماذج 2026 يمكن أن تخطئ، خصوصاً عندما تكون البيانات المطلوبة خارج سياقها أو حديثة أو غامضة، ولذلك أصبح السؤال الأهم ليس “هل يهلوس النموذج؟” بل “ما الأدوات التي يملكها لاكتشاف الخطأ والتحقق منه قبل تسليم النتيجة؟”.
تشير تقييمات Anthropic الداخلية إلى أن Claude Sonnet 5 خفّض معدلات الهلوسة والمسايرة غير الصحيحة مقارنة بسلفه Sonnet 4.6، كما تحسنت قدرته على مراجعة عمله أثناء تنفيذ المهام الوكيلية. لكن هذه نتائج خاصة بمنهجية الشركة ولا تعني أنه الأقل هلوسة في كل المجالات أو أمام كل المنافسين، ولذلك تظل الاستشهادات والمصادر والتحقق الخارجي ضرورية في الاستخدامات القانونية والطبية والمالية والهندسية الحساسة.
يوفر Gemini Grounding مباشراً مع Google Search في السيناريوهات المدعومة، ما يسمح بربط الإجابة بالمعلومات الحية بدلاً من الاعتماد على معرفة النموذج فقط. وفي المقابل توفر منظومة OpenAI البحث على الويب والبحث داخل الملفات وتشغيل الأكواد والأدوات، بحيث يمكن للنموذج التحقق من بعض النتائج حسابياً أو الرجوع إلى مصادر خارجية. وأفضل ممارسة في الأنظمة المهنية هي تصميم سير العمل بحيث يُجبر النموذج على إظهار المصدر أو تنفيذ تحقق مستقل بدلاً من الاعتماد على ثقته اللغوية.
بيئة العمل والتكامل المؤسسي: النظام البيئي لكل منصة
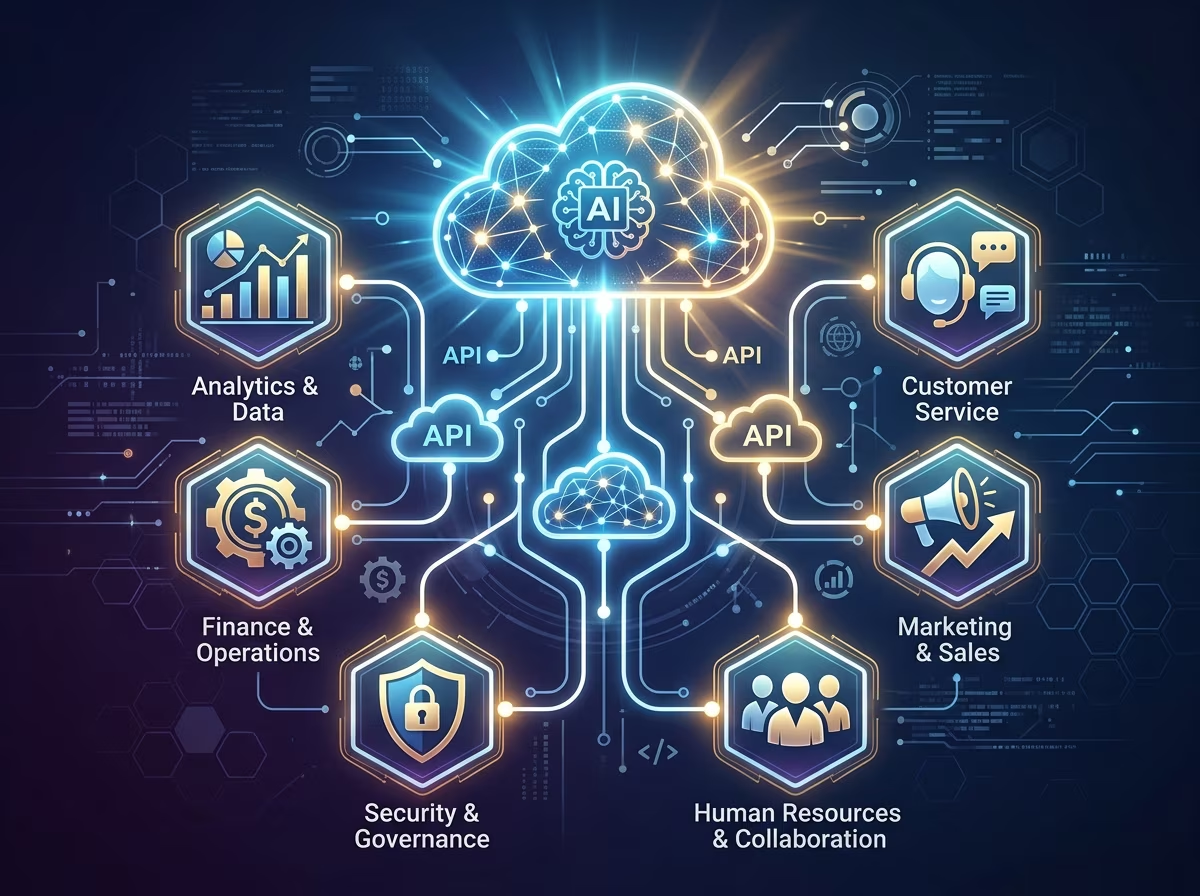
أصبح النظام البيئي المحيط بالنموذج عاملاً قد يكون أهم من فرق بسيط في أي Benchmark؛ فالموظف لا يريد إجابة ممتازة ثم يقضي نصف ساعة في نقلها بين البريد والملفات والجداول. المنافسة الحقيقية أصبحت حول قدرة الذكاء الاصطناعي على الوصول إلى سياق المؤسسة، واستخدام التطبيقات، وتنفيذ الإجراءات مع الاحتفاظ بإشراف المستخدم وصلاحياته.
- النظام البيئي لشركة Google (Gemini): يتمتع بأعمق تكامل أصلي مع Google Workspace. ففي 2026 أصبح Gemini قادراً على تنسيق مهام عابرة للتطبيقات بين Gmail وDrive وDocs وSheets وSlides وChat، مثل جمع المعلومات من الرسائل والملفات ثم إنشاء مستند أو جدول أو عرض منظم منها مع بقاء المستخدم داخل بيئة Workspace.
- منظومة OpenAI (ChatGPT Work وCodex): توسعت من الدردشة إلى تنفيذ العمل. يستطيع ChatGPT Work جمع المعلومات عبر التطبيقات والملفات والويب وإنتاج مستندات وجداول وعروض وتطبيقات، بينما يركز Codex على المستودعات والطرفية وبيئات التطوير واستخدام الحاسوب. كما تسمح منظومة Plugins وربط التطبيقات بتوسيع قدرات ChatGPT إلى خدمات خارجية بدلاً من حصره في بيئة شركة واحدة.
- النظام البيئي لشركة Anthropic (Claude Code وCowork): يركز بقوة على تنفيذ العمل بواسطة الوكلاء؛ فـClaude Code موجه للمستودعات والتطوير واستخدام الطرفية والأدوات، بينما توسعت Claude Cowork إلى تدفقات العمل المكتبية والمؤسسية، مع Connectors وMCP وتكاملات تشمل أدوات Microsoft 365 في البيئات المدعومة.
التكلفة واستهلاك واجهات برمجة التطبيقات (API Pricing & Token Efficiency)
للمطور الذي يبني منتجاً تجارياً، لا يكفي النظر إلى سعر مليون Token فقط؛ فالنموذج الأغلى قد ينهي المهمة بعد محاولات وأدوات أقل، بينما يكون النموذج الأرخص أفضل لملايين الطلبات البسيطة. ومع ذلك تظل أسعار الإدخال والإخراج نقطة بداية مهمة، مع الانتباه إلى أن السياق الطويل والتخزين المؤقت وFast/Priority Processing والأدوات والبحث قد تخضع لتسعير إضافي.
- Claude Sonnet 5 وOpus 5: يبلغ السعر الأساسي لـSonnet 5 نحو 2 دولار لكل مليون Token إدخال و10 دولارات للإخراج، ما يجعله نموذجاً جذاباً للمهام الوكيلية والإنتاجية على نطاق واسع. أما Opus 5 فيبدأ من نحو 5 دولارات للإدخال و25 دولاراً للإخراج، ويستهدف المهام الأصعب التي تبرر تكلفة أعلى. وتوفر Anthropic أيضاً Prompt Caching ومعالجة Batch لتقليل تكلفة أنماط الاستخدام المناسبة.
- OpenAI GPT-5.6 Sol وGPT-6 Astra: يبلغ تسعير GPT-5.6 Sol الحالي نحو 4 دولارات لكل مليون Token إدخال و20 دولاراً للإخراج خلال فترة التسعير الترويجي المعلنة، بينما يبلغ GPT-6 Astra نحو 10 دولارات للإدخال و50 دولاراً للإخراج. وتوجد نماذج GPT-5.6 Terra وLuna الأرخص للمهام التي لا تحتاج إلى أعلى مستوى من القدرة، وهو ما يسمح ببناء Routing اقتصادي بين مستويات مختلفة.
- Gemini 3.8 Flash: يقدم أحد أكثر الأسعار عدوانية بين النماذج المتقدمة، بسعر تمهيدي يبلغ نحو 0.75 دولار لكل مليون Token إدخال و3.75 دولارات للإخراج حتى نهاية ديسمبر 2026، مع إعلان Google عن ارتفاع السعر القياسي بعد ذلك. وعندما تكون المهمة عالية الحجم وتحتاج أيضاً إلى سياق مليون Token والوسائط والأدوات، يصبح فرق التكلفة مهماً جداً في تصميم المنتج.
مصفوفة المقارنة المباشرة: جدول فني لأبرز الخصائص في سبتمبر 2026
بدلاً من منح النماذج درجات ذاتية مثل 9.8 من 10، يلخص الجدول التالي خصائص قابلة للتحقق تساعدك على اتخاذ قرار هندسي أكثر دقة. يجب تذكر أن الخدمات والتسعير تتغير بسرعة، وأن بعض الميزات تختلف بين تطبيق المستهلك وواجهة API والخطة المستخدمة.
| المعيار التقني | Claude 5 | ChatGPT / OpenAI | Gemini 3.8 |
|---|---|---|---|
| النماذج المرجعية الحالية | Sonnet 5 / Opus 5 | GPT-5.6 Sol / GPT-6 Astra | Gemini 3.8 Flash |
| نافذة السياق | نحو 1M Token | نحو 1.05M Token | 1,048,576 Token |
| أقصى إخراج للنموذج المرجعي | حتى 128K | حتى 128K | 65,536 |
| البرمجة والوكلاء | Claude Code، أدوات، طرفية، Computer Use | Codex، Work، أدوات، طرفية، Computer Use | Code Execution، Computer Use، Search، Agents |
| المدخلات متعددة الوسائط في API المرجعي | نص، صور، PDF | نص وصور للنماذج الرائدة، مع نماذج وأدوات متخصصة لبقية الوسائط | نص، صور، صوت، فيديو، PDF |
| الصوت الفوري | ميزات صوتية على مستوى المنتج، وليست محور النموذج الأساسي | GPT-Live-1 داخل ChatGPT Voice | Gemini 3.8 Live وExtended Thinking |
| سعر API المرجعي لكل مليون Token إدخال/إخراج | Sonnet 5: $2 / $10 Opus 5: $5 / $25 | GPT-5.6 Sol: $4 / $20 GPT-6 Astra: $10 / $50 | 3.8 Flash: $0.75 / $3.75 حتى نهاية 2026 وفق السعر التمهيدي |
سيناريوهات الاستخدام الحقيقية: دليلك لاختيار النموذج الأنسب لمهنتك اليومية
بدلاً من اختيار منصة واحدة بناءً على شهرتها أو ترتيب مؤقت في Benchmark، حدد أولاً طبيعة المهمة، وحجم السياق، وعدد مرات التشغيل، والأدوات المطلوبة، وحساسية الخطأ، ثم اختبر النماذج على عشرات الحالات الحقيقية من عملك. ويمكن استخدام السيناريوهات التالية كنقطة بداية عملية:
- يميل Claude Sonnet 5 أوOpus 5 إلى أن يكون مناسباً إذا كنت:
- تعمل على مستودعات برمجية قائمة ومعقدة وتحتاج إلى وكيل يتتبع الأخطاء ويكتب الاختبارات وينفذ تغييرات متعددة الملفات عبر Claude Code.
- تتعامل مع مستندات وتقارير طويلة وتحتاج إلى المحافظة على أسلوب وتعليمات متسقة داخل سياق قد يصل إلى مليون Token.
- تبحث عن توازن قوي بين قدرات الوكلاء والتكلفة، حيث يوفر Sonnet 5 فئة سعرية أقل من النماذج فائقة القدرة مع إمكانات واسعة في استخدام الأدوات.
- يميل ChatGPT مع GPT-5.6 أوGPT-6 Astra إلى أن يكون مناسباً إذا كنت:
- تحتاج إلى منصة عامة تجمع البحث والاستدلال والبرمجة وتحليل الملفات وتشغيل الأكواد واستخدام الحاسوب وإنشاء المخرجات داخل سير عمل واحد.
- تعمل على مهام هندسة برمجيات أو بيانات وتتوقع من Codex أوChatGPT Work الانتقال من التحليل إلى التنفيذ والتحقق وإنشاء الملفات النهائية.
- تستخدم التفاعل الصوتي بكثافة وتريد تجربة صوتية فورية تستطيع العمل مع البحث والذاكرة ومحتويات المحادثة نفسها.
- يميل Gemini 3.8 إلى أن يكون مناسباً إذا كنت:
- تعمل بصورة مكثفة داخل Google Workspace وتريد تنفيذ مهام تجمع Gmail وDrive وDocs وSheets وSlides بدلاً من نقل البيانات بينها يدوياً.
- تحتاج إلى إدخال الفيديو والصوت والصور وPDF والنص معاً، أو بناء تطبيقات ذات سياق ضخم ومعالجة متعددة الوسائط.
- تبني نظاماً عالي الحجم وتصبح تكلفة ملايين أو مليارات الرموز عاملاً رئيسياً، مع حاجتك في الوقت نفسه إلى أدوات ووكلاء وقدرات برمجية قوية.
مستقبل الصراع التقني: الوكلاء المستقلون لم يعودوا مستقبلاً بل واقعاً تشغيلياً
أكبر تغير بين المنافسة القديمة والمشهد الحالي أن AI Agents خرجوا من مرحلة العروض التجريبية. المطلوب اليوم من النظام ليس أن يخبرك كيف تصلح البرنامج أو تنشئ التقرير، بل أن يقرأ الملفات، ويخطط، ويفتح التطبيقات، ويستخدم المتصفح أو الطرفية، ويعدل البيانات، ويختبر النتيجة، ثم يطلب تدخل الإنسان فقط عندما يحتاج إلى قرار أو صلاحية أو مراجعة نهائية. وهنا يصبح “مدى استقلالية النموذج مع بقاء السيطرة البشرية” معياراً مركزياً في المقارنة.
تسلك الشركات الثلاث طرقاً مختلفة للوصول إلى هذا الهدف: تدفع OpenAI بمنظومة ChatGPT Work وCodex واستخدام الحاسوب والأدوات والوكلاء المتعددين، بينما تبني Anthropic منظومة Claude Code وCowork وManaged Agents وMCP حول المهام الطويلة، في حين تدمج Google Gemini عميقاً في Workspace وتدفع بمنصة Antigravity وقدرات Computer Use وSearch وMaps والوسائط الحية. لذا سيكون التفوق المستقبلي أقل ارتباطاً بعدد نقاط Benchmark وأكثر ارتباطاً بنسبة المهام الحقيقية التي يمكن للنظام إنهاؤها بنجاح وبأقل تكلفة وإشراف.
الخلاصة والقرار النهائي: ChatGPT أم Claude أم Gemini في 2026؟
لا يوجد في سبتمبر 2026 فائز مطلق يصلح لكل الاستخدامات. كما أصبحت الفروق بين النماذج تتغير بسرعة أكبر من أي وقت سابق، ولذلك فإن القرار المهني الأفضل يبدأ من طبيعة المهمة وليس من اسم الشركة. ومع وصول المنصات الثلاث إلى سياقات تقارب المليون Token وقدرات استدلال وأدوات متقدمة، أصبحت بيئة التنفيذ والتكلفة والوسائط والتكاملات هي العوامل التي تفرق بينها عملياً.
- إذا كان محور عملك هندسة البرمجيات الوكيلية، تصحيح الأنظمة القائمة، والمشروعات الطويلة عبر Claude Code، فإن Claude Sonnet 5 وOpus 5 يستحقان أن يكونا ضمن أول النماذج التي تختبرها على بياناتك الفعلية.
- إذا كنت تريد منصة عامة تنقل المهمة من البحث والاستدلال إلى الكود والملفات واستخدام الحاسوب والتنفيذ، فإن منظومة ChatGPT وCodex مع GPT-5.6 وGPT-6 Astra تقدم نطاقاً واسعاً للغاية من الأدوات وسير العمل.
- إذا كانت الأولوية هي الوسائط المتعددة، Google Workspace، الحوار الصوتي والمرئي الحي، أو تكلفة API على نطاق كبير، فإن Gemini 3.8 يقدم تركيبة قوية جداً ينبغي اختبارها قبل اتخاذ القرار النهائي.
أما الممارسة المهنية الأقوى في 2026 فهي بناء Hybrid AI Workflow بدلاً من الولاء لنموذج واحد: يمكن استخدام نموذج اقتصادي للفرز والمعالجة الجماعية، ونموذج متخصص للبرمجة، ونموذج أقوى للتحقق من القرارات الحساسة، مع إضافة البحث أو الاختبارات الآلية أو المراجعة البشرية عند الحاجة. بهذه الطريقة يصبح الذكاء الاصطناعي بنية إنتاجية قابلة للقياس، وليس مجرد مسابقة لمعرفة أي نافذة دردشة تعطي الإجابة الأكثر إبهاراً.